Arkitektur
PDQ kombinerar avancerad automation med end-to-end aktiv metadatahantering. Det är grunden för dataoperationer som är effektiva, transparenta och fullt automatiserade.
Genom att integrera PDQ i din infrastruktur säkerställer du att modellering, kvalitet, versionering, integration, kodgenerering och orkestrering hänger ihop som en enhet — inte som en samling löst kopplade verktyg.
Från källa till levererat värde
Ingest, Data Lake Service och Data Warehouse Automation i ett sammanhängande flöde — med katalog, monitorering, orkestrering, automatisering, observerbarhet och spårbarhet över hela kedjan.
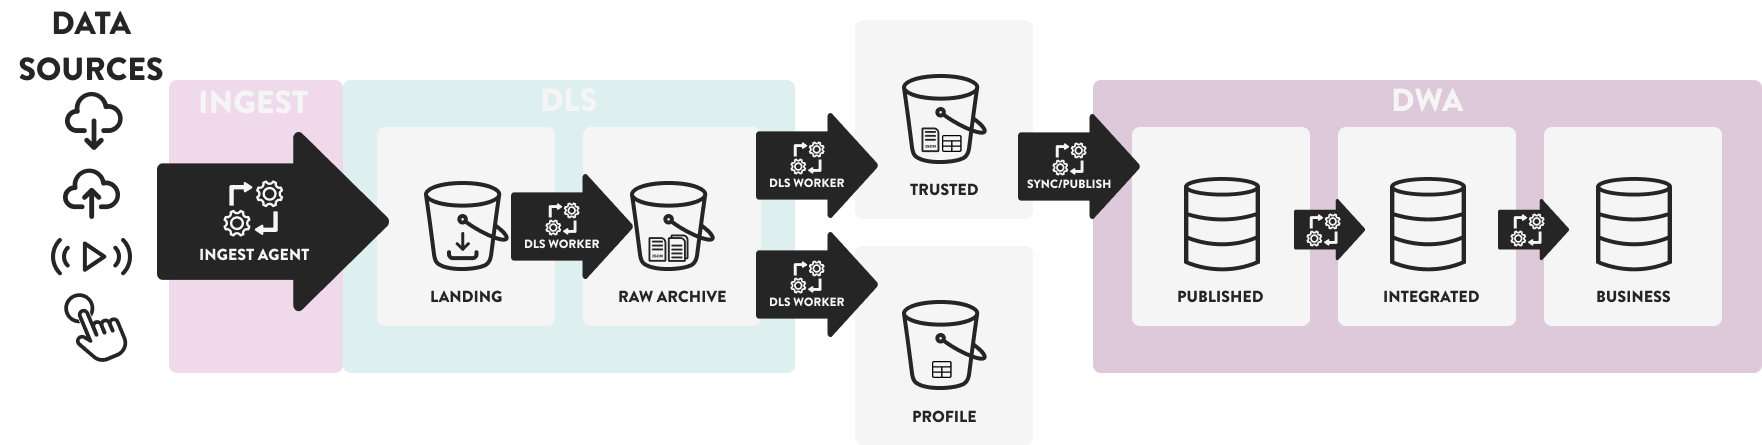
PDQ:s referensarkitektur. Varje steg är styrt av aktiv metadata, vilket gör flödet spårbart från datakälla till levererad rapport.
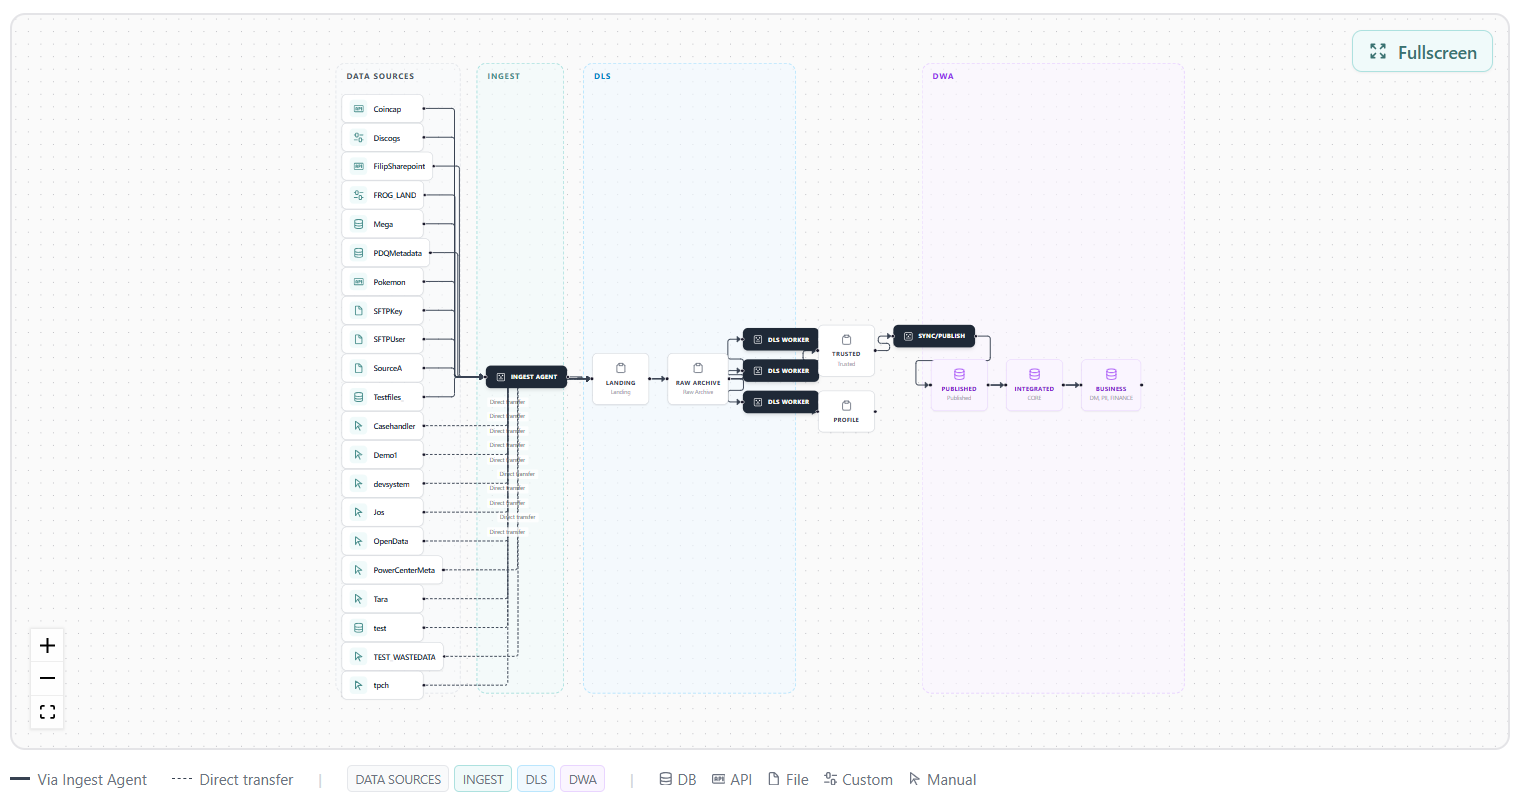
Samma flöde ritas live på PDQ:s dashboard, utifrån de system, källfiler och modeller som faktiskt är konfigurerade i din installation. Heldragna linjer är leveranser via Ingest-agenten, streckade linjer är direktöverföringar, och ikonen på varje källa visar om det är en databas, ett API, en filkälla, en custom-koppling eller en manuell leverans.
Varje steg har ett eget ansvar. Det gör att ett fel går att placera, och att ett lager går att byta utan att resten skrivs om. Metadatan styr körningen: härkomst, versioner och regelefterlevnad blir biprodukter av flödet i stället för separata projekt.
Stegen i detalj
Källor — Datakällor
Vad Filer, API:er, strömmar och databaser — källsystemen som de faktiskt ser ut, utan förarbete.
Varför Källor ändrar sig utan att fråga. Plattformen måste tåla det utan att någon skriver om en pipeline.
Hur Varje källa beskrivs som metadata: anslutning, schema och laddningsfönster. En ny källa är en konfiguration, inte ett projekt.
Ingest — Ingest Agent
Vad Agenten hämtar data och lägger den i Landing utan att förändra den.
Varför Det som anlände måste gå att skilja från det vi gjorde med det. Annars går ingen avstämning att göra i efterhand.
Hur Agenten kör nära källan, skriver oförändrade filer och stämplar varje leverans med tidpunkt och ursprung.
DLS — Data Lake Service
Vad Landing → Raw Archive → Trusted, med Profile vid sidan om.
Varför Rådata bevaras oförändrad medan kvalitetssäkringen sker på vägen mot Trusted. Två olika jobb, två olika lager.
Hur Profilering och kvalitetsregler körs som en del av flödet. Endast hårda fel som saknad affärsnyckel och helt felaktig struktur stoppas och når aldrig Published; resten bearbetas, eftersom vi inte kan stoppa alla användningsfall i det här läget. Avvikelsen registreras för spårbarhet.
DWA — Warehouse Automation
Vad Published → Integrated → Business. Från kvalitetssäkrad källdata till en integrerad, historiserad modell och slutligen ett affärsnära leveranslager.
Varför Integrated är kärnan: en normaliserad och historiserad modell där varje värde har en giltighetsperiod. Det är den som gör frågan "vad visste vi då?" besvarbar.
Hur Modellen är källan. Laddningslogik, historisering och tidpunktsvyer genereras ur den — ingen skriver historiseringslogik för hand.
Leverans — Ut till verksamheten
Vad Rapporter och BI, API:er, AI- och ML-arbetsflöden samt direkt SQL-åtkomst.
Varför Alla konsumenter läser samma kvalitetssäkrade underlag. En siffra — inte en siffra per verktyg.
Hur Affärslagret exponerar affärsnära vyer ovanpå den normaliserade modellen. Komplexiteten ligger närmast modellen, inte närmast användaren.
Aktiv metadata — Kapabiliteter runt hela kedjan
Vad Datakatalog, monitorering, orkestrering, automatisering, observerbarhet och spårbarhet.
Varför De omger hela kedjan i stället för att sitta i var sitt verktyg. Metadatan beskriver inte bara systemet — den kör det.
Hur Aktiv metadata styr varje steg, så härkomst, versioner och regelefterlevnad faller ut ur körningen i stället för att dokumenteras vid sidan om.
Teknikagnostisk i grunden
Plattformen sitter ovanpå din stack — inte tvärtom.
Byt databas, byt lagring, byt moln. Modellen, logiken och metadatan följer med — det gör leverantörshävstången verklig i stället för teoretisk.
Lagren är oberoende av varandra: byte av databas eller lagring är en konfigurationsändring, byte av moln en migrering.
| Lager | Alternativ som stöds |
|---|---|
| Valfri databas | Snowflake, Databricks, SQL Server, Synapse, Fabric, PostgreSQL |
| Valfri lagring | Azure Blob, Amazon S3, CEPH, Swift, MinIO |
| Valfritt moln | Azure, AWS, Cleura |
Vad plattformen faktiskt gör
Modellering och kodgenerering
Datamodellen är källan. Laddningslogik, historisering och strukturer genereras ur den — konsekvent oavsett vem som bygger, och utan handskriven ETL som glider isär över tid.
Styrning i målet, inte bredvid det
Samma genereringskörning som bygger tabellerna dokumenterar och klassificerar dem också. Kolumn- och tabellkommentarer, primärnycklar, främmande nycklar, unika villkor, kategoritaggar och känslighetstaggar genereras ur de deklarationer som redan gjorts i datakontraktet och modellen — så en klassificering som satts en gång på ett källfält anländer på målkolumnen, även på de normaliserade barntabeller som ärver nyckeln.
Kvalitet och profilering
Profilering och kvalitetsregler körs som en del av flödet, inte som ett efterarbete. Avvikelser fångas där de uppstår och stoppar det som ska stoppas.
Orkestrering och drift
Beroenden, körordning, omkörningar och larm hanteras centralt. Produktionsklart från dag ett i stället för månader av ställningsbygge.
Aktiv metadata
Metadatan beskriver inte bara systemet — den kör det. Härkomst, versioner och regelefterlevnad är biprodukter av körningen, inte separata projekt. Den är också portabel: REST-API:et serverar hela registret, och varje exekvering genererar OpenLineage-händelser, så härkomsten når den katalog du redan kör i stället för att stanna inne i konsolen.
DLS och DWA — vad som händer var
| Steg | Lager | Vad som händer |
|---|---|---|
| Ingest | In i plattformen | Ingest-agenten hämtar data från filer, API:er, meddelandeköer och databaser och lägger den i Landing utan att förändra den. |
| DLS | Data Lake Service | Landing → Raw Archive → Trusted, med Profile vid sidan om. Rådata bevaras oförändrad; konformitet sker på vägen mot Trusted. |
| DWA | Data Warehouse Automation | Published → Integrated → Business. Från kvalitetssäkrad källdata till integrerad, historiserad modell och slutligen affärsnära leveranslager. |
| Leverans | Ut till verksamheten | Rapporter, API:er, dashboards, AI- och ML-arbetsflöden samt direkt SQL-åtkomst — allt från samma kvalitetssäkrade underlag. |
Databehandlingslager
| Lager | Syfte |
|---|---|
| Landing | Ingångspunkten för data, där den initialt matas in. |
| Raw Archive | Lagrar rådata på obestämd tid, organiserad och märkt för revisionsändamål. |
| Trusted | Bearbetar och publicerar data i ett standardiserat, lättanvänt format. |
| Profile | Analyserar data för att upptäcka nya och saknade datapunkter utan att störa laddningsprocessen. |
| Published | Tillhandahåller valt tabellformat för överenskommen källleverans och underlättar SQL-baserad dataåtkomst. |
| Integrated | En integrerad central affärskonceptdatamodell som använder ensemble-datamodelleringsmetodik. |
| Business | Användningsfallsdrivna affärsdataset designade för specifika scenarier, anpassade efter unika affärs- och domänspecifika definitioner och regler. |
Nästa steg
- Plattformsguide — lager-för-lager-genomgång av INGEST, DLS, DWA och QPI
- Kapabiliteter för datahantering — hela listan över vad plattformen gör, med länkar in i detaljerna
- Vad som landar i målmiljön — kommentarerna, nycklarna, villkoren, taggarna och maskeringen som genereras in i din databas
- Ditt första flöde — hela vägen från en källfil till en schemalagd dataprodukt
- Driftsättning — installera och kör plattformen i din egen miljö
- Daglig drift — övervakning och drift av plattformen